构建坚实的数据基石 数据处理与存储支持服务如何赋能大数据时代
在数字经济时代,数据已成为核心生产要素。面对海量、多样、高速增长的数据,企业能否高效地存储、处理并挖掘其价值,直接决定了其在市场竞争中的成败。为此,专业的数据处理和存储支持服务应运而生,其核心使命正是:能够支持大量的数据存储和访问,满足用户的大数据处理需求。
一、海量数据存储:从“存得下”到“存得好”
“支持大量的数据存储”绝非简单的容量堆砌。现代存储支持服务需具备以下关键能力:
- 弹性扩展架构:采用分布式存储系统(如对象存储、分布式文件系统),支持PB级甚至EB级容量平滑扩展,企业可按需增长,避免前期过度投资。
- 多模态数据兼容:同时支持结构化数据(如关系型数据库)、半结构化数据(如JSON、日志)和非结构化数据(如图片、视频、文档),满足不同业务场景的存储需求。
- 高可靠与高持久性:通过多副本、纠删码、跨地域容灾等技术,确保数据持久性达到99.999999999%(11个9),保障业务连续性。
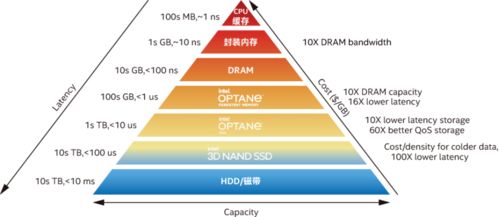
- 分层存储与成本优化:根据数据访问频率自动分层(热、温、冷、归档),在保证性能的同时显著降低存储成本。
二、高效数据访问:让数据“触手可及”
存储的价值在于访问。面对大规模数据,高速、稳定的访问能力是关键:
- 高并发低延迟:通过缓存加速、并行读取、智能预取等技术,支撑数千甚至数万QPS的并发访问,满足实时查询与分析需求。
- 统一命名空间与全局索引:跨地域、跨集群提供统一访问入口,用户无需关心数据物理位置,即可高效检索与获取数据。
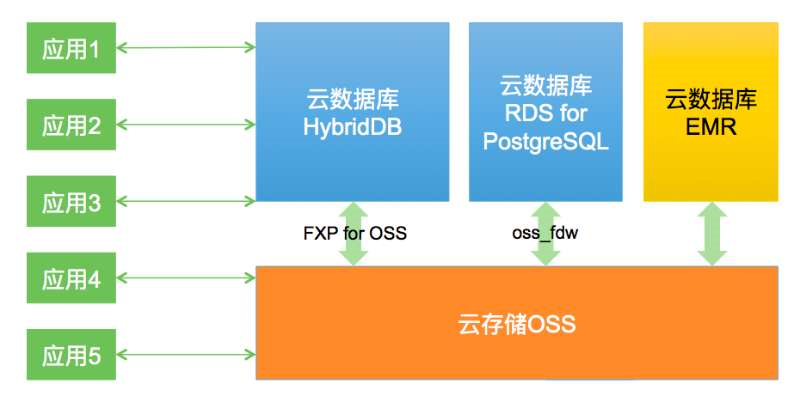
- 协议兼容与开放接口:支持POSIX、S3、HDFS、NFS等多种标准协议,并提供RESTful API,便于各类应用与大数据组件(如Hadoop、Spark、Flink)无缝集成。
- 数据本地性优化:在计算与存储分离架构下,通过智能调度将计算任务推向数据所在节点,减少网络传输开销,提升处理效率。
三、满足大数据处理需求:存储与计算的协同
大数据处理不仅需要“存”和“取”,更需要存储系统与计算引擎深度协同:
- 吞吐量保障:针对批处理场景,提供高聚合带宽(如数十GB/s),确保海量数据扫描、ETL作业高效运行。
- 元数据管理:高效管理数十亿文件/对象的元数据,支持快速列表、重命名、权限校验等操作,避免元数据服务成为瓶颈。
- 数据一致性与版本控制:在并发写入与更新场景下,提供强一致性或最终一致性模型,并支持快照、版本回滚,保障数据处理的准确性。
- 安全与合规:集成细粒度访问控制、传输加密、静态加密、审计日志,满足数据安全法与行业合规要求。
四、典型应用场景
- 数据湖与湖仓一体:作为统一存储底座,支撑原始数据沉淀与多引擎分析。
- AI/ML训练:高速存储访问加速海量样本读取,缩短模型训练周期。
- 日志与监控分析:高吞吐写入与实时检索,支撑可观测性平台。
- 备份与归档:低成本冷存储满足长期数据留存与合规需求。
五、
数据处理和存储支持服务是企业大数据战略的基础设施。通过构建弹性、可靠、高效、开放的存储与访问体系,并持续优化与计算引擎的协同,企业才能真正“存得下、取得到、算得快”,充分释放数据要素价值,在数字化浪潮中赢得先机。
如若转载,请注明出处:http://www.51xmlong.com/product/103.html
更新时间:2026-11-21 07:55:37